Physics-informed GNN · 第 4 模块
AI 入门 · 神经网络基础
前三章让我们能够计算电网的运行工况。现在换一个问题:能否从一组输入、输出样本中,训练一个函数来学习它们之间的关系? 在用图神经网络预测电网状态之前,我们先理解神经网络如何计算、训练究竟改变了什么,以及较小的误差能说明什么。
1. 从物理计算到从数据中学习
预备知识:函数、矩阵乘法、导数,以及潮流模型的输入和输出。不要求已有机器学习基础。可以先看图和操作滑块,再结合例题阅读后面的批量梯度公式。
人工智能(AI) 是较广的领域;机器学习(ML) 包括从数据中学习规律的方法;深度学习(DL) 使用具有多层表示的神经网络。本章从一个只有一层隐藏层的多层感知机 MLP 入手。这里的“训练”是数值优化:调整函数里的参数,而不是调用一个对话模型。
- 1 · 物理与数据潮流计算生成运行工况与电压标签。
- 2 · 可训练函数本章用 sin(x) 拆解 MLP 的组成。
- 3 · 训练与验证优化参数,并检查未参与更新的数据。
- 4 · 走向 GNN后续显式加入节点、线路与物理约束。
先确定任务,再选择网络
监督回归的每个样本提供输入 x 和数值目标 y。选择一族函数 fθ,再利用训练样本调整参数 θ;训练后对新输入进行计算,称为推理(inference)。分类任务则预测类别。后续 N-1 安全分析既可以做安全类别预测,也可以先回归电压、电流或约束裕度;任务和标签必须先定义清楚。
本章先用一个能直接看见真实答案的例子:
默认不加噪声;滑块可以给训练标签添加高斯噪声。直线 ŷ = ax + b 只能改变斜率和截距,无法弯曲以跟随整个正弦波。这是所选模型类别的表达限制。神经网络加入非线性特征,也仍需要合适的数据和有效的优化才能拟合得好。如果真实关系本来就是线性的,直线完全可能是合理选择。
2. 神经元:仿射变换,再经过激活函数
输入权重 w 和隐藏偏置 b 决定特征的位置与形状;输出权重 v 和偏置 c 把特征组合成预测。参数是一组待学习的数,并不是训练样本。第一个实验由你手动设置参数,后面的训练实验才会自动调整多个神经元的参数。
实验 A · 用手“弯”出一条曲线
拖动即更新 · 无需加载 Python隐藏响应与输出
当前观察点的计算
w 改变方向和陡峭程度,b 改变激活发生的位置;v 缩放并可翻转特征,c 上下移动输出。导数表示观察点处的局部斜率。
先把 w 改为 −1,再恢复 w = 1 并改变 b。随后把 v 改为 −1。哪个参数改变弯曲发生的输入位置,哪个参数翻转输出?选择线性激活后,无论怎样拖动,输出仍然是一条直线。
为什么必须引入非线性?
如果移除非线性激活,连续的仿射层仍然可以合并成一个仿射映射。激活函数改变了网络能表达的形状。可以对照阅读 《动手学深度学习》MLP 章节。
| 激活 | 公式 | 导数 | 观察重点 |
|---|---|---|---|
| tanh | tanh(z) | 1 − tanh²(z) | 平滑、可正可负;进入饱和区后梯度变小 |
| Sigmoid | 1 / (1 + exp(−z)) | σ(z)(1 − σ(z)) | 输出在 0 与 1 之间;同样存在饱和 |
| ReLU | max(0, z) | z > 0 时为 1,z < 0 时为 0 | 分段线性;z = 0 不可导,代码约定取 0 |
| Linear | z | 1 | 对照组:不产生非线性特征 |
这里选择的是隐藏层激活。回归输出保持线性,以便预测正值和负值。Sigmoid 输出常用于配合适当分类损失的二分类概率;仅在隐藏层使用 sigmoid,并不会把当前回归任务变成分类任务。
3. 多个隐藏特征组成 MLP
对于一个输入、H 个隐藏单元和一个输出:
每个隐藏单元贡献 w₂ⱼhⱼ,输出层将这些贡献与 b₂ 相加。训练同时学习“特征长什么样”和“如何组合特征”。仅看输出权重大小,不能判断一个特征有多重要,还要看它在输入区间内的取值。实验会按照训练区间内加权贡献的 RMS 选出三个特征,并把其余项合成第四条曲线,因此逐点相加仍然精确得到完整输出。
把矩阵维度读顺
统一采用一行对应一个样本的约定,与原始 Notebook 的 NumPy 代码一致。N 个一维输入、H 个隐藏单元时:
全 1 列向量把同一偏置加到每个样本。H 表示宽度,Hact 表示激活矩阵。参数总数为 H + H + H + 1 = 3H + 1:H = 16 时为 49,H = 32 时为 97。若使用列向量表示单个输入,公式中的转置关系会改变;一次推导中需要保持约定一致。
4. 训练:损失、梯度与一次更新
均方误差(MSE) 计算训练样本上的平均平方误差:
η 是学习率。反向传播沿计算图应用链式法则来求梯度,梯度下降再用梯度更新参数,两者是不同的步骤。本实验每次使用全部训练样本计算梯度,一轮 epoch 对应一次参数更新。小批量训练则在遍历全部数据的一轮中进行多次更新。
- ① 前向传播X → Z → H → Ŷ
- ② 计算损失Ŷ, Y → L
- ③ 反向传播L → ∇θL
- ④ 更新参数θ ← θ − η∇θL ↺
例题:一个参数如何更新一次?
取单个样本 x = 1、y = 0.8,使用 tanh,参数为 w = 1、b = 0、v = 0.5、c = 0。前向计算得到 z = 1、h ≈ 0.761594、ŷ ≈ 0.380797、L ≈ 0.175731。若只更新 w,学习率 η = 0.1:
梯度为负,因此本次更新增加 w。如果只改变 w,损失约下降到 0.172686。完整训练会先基于同一组旧参数求出所有参数的梯度,再统一更新。一次成功的下降,不能保证整个非凸训练问题一定收敛。
展开批量反向传播:与前向公式保持相同的维度约定
对于 tanh 和一维输出,令 D = ∂L/∂Ŷ。下面对样本求和后,偏置梯度保留行向量形状。
逐元素乘法把上游梯度与每个激活函数的导数组合起来。Python 标准库源码用标量循环表达同一计算,使每个链式因子都可见。PyTorch autograd 等框架可以自动计算图中的导数,但仍需要我们定义数据、损失和优化器。
把优化效果与泛化能力分开
学习率过小可能进展很慢,过大可能振荡或发散;数值有限也不等于已经收敛。宽度改变表达能力,轮数与学习率影响优化;拟合不佳可能来自这两类原因。参数更多并不自动意味着过拟合。
训练误差衡量参与更新的样本;验证集用来在其他样本上比较设置;测试集留给开发选择完成后的最终评估。反复根据测试结果调参,会把测试信息泄漏进开发过程。参见 Google 的数据划分说明。本实验用带噪训练标签训练,用不重合输入上的已知干净函数验证;加噪后,两种误差的目标本来就不同。它没有提供独立测试集结论。
5. 训练网络,观察究竟改变了什么
先比较默认 MLP 与最小二乘直线,再回放 epoch 0 和最后一轮。随后选择 Linear 激活:即使增加宽度,仿射模型仍然无法拟合完整正弦。最后尝试学习率 1,观察数值发散,再调小学习率恢复训练。
实验 B · 训练、比较、回放
真实全批量梯度下降 · 浏览器内计算准备训练…
训练完成后拖动回放。下方曲线、特征与误差都对应所选轮次;Python 使用上方设置重新完整训练。
目标、样本与当前预测
误差随训练变化(纵轴 log₁₀ MSE)
隐藏单元如何拼成输出
改变设置会自动重新训练;固定种子可复现同一设置。训练点分布在 [−π, π],验证采用 160 个不重合的区间内点与干净目标;灰色区域在训练区间外,展示外推,未计入验证指标。当前实验没有独立测试集,不能据此宣称真实任务的泛化性能。
建议每次只改变一个设置,保留随机种子,在相同轮数下比较误差和曲线。增加宽度可能提升拟合能力,但训练不足会掩盖这种能力。增加噪声、减少样本,可以帮助区分“拟合观测点”和“恢复干净函数”;某一次实验不一定会出现过拟合。
6. 运行并修改 Python 实现
上方 JavaScript 实验快速运行显式公式;这里执行的是同一算法的 Python 实现,采用匹配的初始化、随机采样和更新顺序。下方保留原始 NumPy 教学 Notebook;另外整理了一份独立 Notebook,包含当前标准库模型与 Matplotlib 绘图。实验不依赖预训练网络或后台训练服务。
1 · 确认输入 case
运行时复制实验 B 的目标函数、激活函数、宽度、样本数、噪声、学习率、轮数与种子。下面的快照会随控件更新;回放滑块只查看历史参数,不改变 case。
2 · 展开模型源码与依赖(可编辑)
唯一依赖是 Python 标准库 math。dataset() 生成数据;initialize() 初始化参数;predict() 做前向传播;gradient() 手写链式求导;step() 更新权重;train() 组合这些步骤并返回曲线与指标。这里的修改仅用于下一次 Python 运行。
3 · main() 要完成什么?
先复制参数,再调用 train(parameters) 完成数据生成、随机初始化、梯度下降和验证;最后打印误差并返回 answer。最末行 result = main() 把返回值交给绘图面板。修改 parameters 不会改变上方滑块。
首次运行联网下载 Pyodide;训练在浏览器 Worker 内完成,无需账号或 API key。标准库实现便于阅读,大设置下可能比上方 JavaScript 实验慢。可停止运行;刷新页面会清除未下载的代码修改。
准备运行。
输出将在这里显示。
Python 返回的预测(独立于上方回放)
可以取消 parameters["hidden"] = 32 前的注释,或设置 parameters["target"] = "sin2"。若要修改算法,先展开 model.py 阅读 gradient()。一个有用的核对方法是对损失做中心差分:在避开 ReLU 拐点时,应与解析梯度一致。整理后的 Notebook 包含这一检查。
7. 从 MLP 回到电力系统学习任务
回到上一章 pandapower 实现。每个供电状态明确且已收敛的工况,可以形成一个输入—标签样本:负荷、发电、拓扑作为输入,电压、电流或安全裕度作为输出。孤岛或未收敛计算需要保留单独的状态标记,不能伪装成有效的零电压标签。
一个可执行的项目流程是:定义标签与安全判据,生成并核查工况,在拟合预处理步骤之前划分场景,训练基线模型,再评估留出的运行条件。彼此接近的工况及其故障变体应分组处理,避免信息泄漏。电压、电流限值、失供节点与收敛状态需要明确约定。平均电压预测误差小,并不能单独证明 N-1 安全类别预测准确。
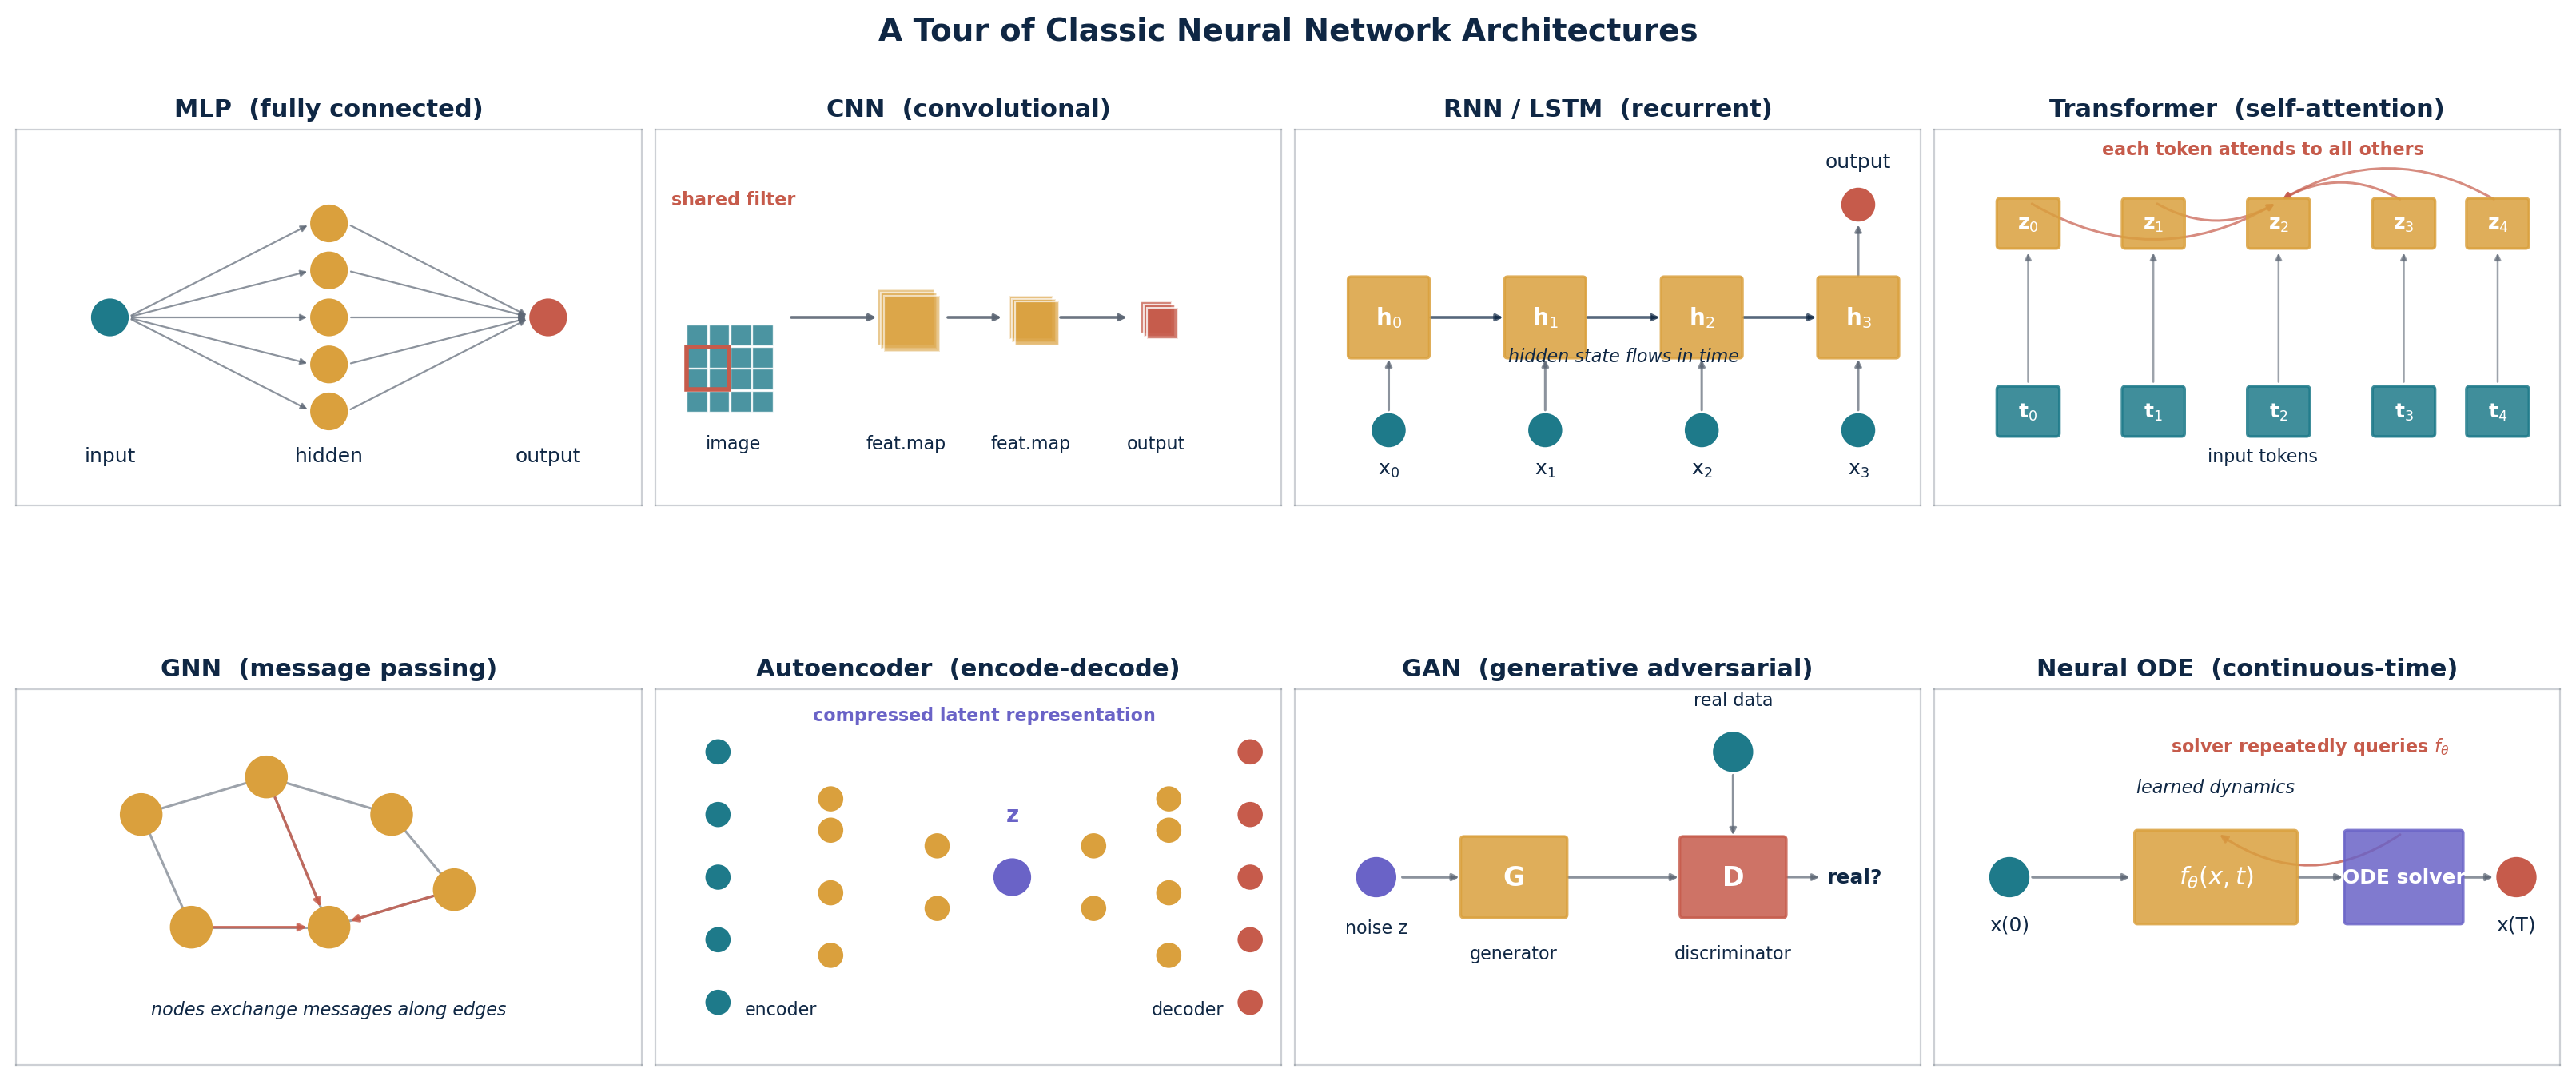
| 架构 | 利用的结构 | 电力系统中的对应 |
|---|---|---|
| MLP | 对固定向量做全连接变换 | 固定节点顺序与拓扑表示下的基线模型 |
| CNN | 在规则网格上共享局部滤波器 | 空间排列信号或网格型测量 |
| RNN / LSTM / GRU | 隐藏状态沿序列传递 | 时序测量与预测 |
| Transformer | 表示元素之间的注意力 | 配合位置或结构信息处理序列、集合 |
| GNN | 沿图连接传递消息 | 节点特征、线路特征及变化的网络连接 |
| Autoencoder / VAE | 编码与重构,或概率潜变量 | 表示学习与异常检测 |
| GAN / diffusion | 用不同目标学习生成分布 | 合成场景;生成结果仍需物理校验 |
图结构提供了有用的归纳偏置,但不会自动满足基尔霍夫定律,也不会保证迁移到所有拓扑。后续 physics-informed 目标可以把数据误差与明确的 AC 方程残差、约束项组合起来;必须说明变量、正负号、归一化与各项权重。本章只训练监督 MLP。
原课件的延伸方向:Neural ODE 与 GFM 建模
原课件把神经网络安排在动力学模型与 Neural ODE 之间。同一种函数逼近思路也可以参数化状态导数 ds/dt = fθ(s, u),再由 ODE 求解器构造轨迹。这改变了输出的含义与训练问题,与静态潮流代理模型属于不同用途;拟合 sin(x) 并没有辨识出 GFM 动态。可以沿另一条 IBR 动态课程路径继续学习。
8. 练习:先预测,再运行,再解释
- 不使用非线性激活,把宽度从 2 增加到 32。为什么仍然无法表示完整的正弦曲线?
- 保留默认种子和宽度,在相同轮数下比较 η = 0.001、0.03、1。区分优化缓慢与数值发散。
- 改为 sin(2x),比较宽度 4、16、32。改变训练轮数后,对表达能力的判断是否变化?
- 使用 16 个训练点、噪声 0.3。训练误差和验证误差各自对什么目标计算?单独检查灰色外推区。
- 选择一个回放轮次,在某个 x 处相加三个特征贡献与其余项。为什么一定等于 MLP 输出?
- 为电网数据集写出输入、标签、单位、拓扑与状态字段、划分分组,以及 N-1 安全判据;指出一种潜在信息泄漏。
自查:能否讲清整个实验?
模型类别决定可能的函数形状,损失规定训练目标,反向传播计算导数,优化器更新参数。验证检查开发时留出的样本,最终评估还需要合适的独立测试集与实际物理任务的指标。拟合正弦曲线或降低训练 MSE,都不足以证明电网安全预测性能。
9. 课件、Notebook 与补充阅读
本网页根据上传的 33 页 Neural Network Basics 课件与 22 单元教学 Notebook 整理,作为当前课程第 4 模块。原文件中的 Week 4 与“下周”属于原有动力学课程背景;下载文件保留原背景。网页新增了通向 GNN 的衔接、参数实验、统一的行样本公式,以及验证与外推的区别。
原材料中的架构概览图